China eröffnet eine neue Front im KI-Chip-Krieg
Der Burggraben, über den niemand sprach
Jahrelang drehte sich die KI-Hardware-Diskussion um eine einzige Frage: rohe Rechenleistung. Wer hat die meisten Teraflops, die breiteste Speicherbandbreite, die schnellsten Verbindungen. Nvidia gewann dieses Rennen mit großem Abstand, und die Erzählung beruhigte sich in einer bequemen Gewissheit - um mit Nvidia zu konkurrieren, braucht man einen besseren Chip.
Was diese Erzählung übersieht, ist, dass Nvidias eigentlicher Vorteil nie nur der Chip war. Es war CUDA.
CUDA ist Nvidias proprietäres Software-Ökosystem: das Programmiermodell, die Bibliotheken, die Compiler-Toolchain, jahrzehntelange Entwickler-Tutorials und Produktionsdeployments, die es zur Standardumgebung für KI-Entwicklung gemacht haben. Ein schnellerer Chip ist nutzlos, wenn ihn niemand programmieren kann, und CUDA macht das Programmieren von Nvidia-Hardware zum Weg des geringsten Widerstands. Jedes KI-Unternehmen, jedes Forschungslabor, jeder Cloud-Anbieter optimierte für CUDA, weil CUDA das einzige Spiel in der Stadt war.
DeepSeek und Huawei haben diese Annahme gerade in Frage gestellt.
TileLang: CUDAs erste glaubwürdige Alternative
Am 30. September gab DeepSeek über den chinesischen Social-Media-Dienst WeChat bekannt, dass es mit Huawei zusammengearbeitet hat, um eine vollständige Open-Source-Programmier-Toolchain für Huaweis Ascend-KI-Chips zu entwickeln. Das Kernstück ist TileLang.
TileLang ist eine höhere Programmiersprache, die speziell für die KI-Beschleunigerentwicklung entwickelt wurde. DeepSeek beschreibt es als ein einfacheres Programmiermodell, das die niedrige Komplexität chipspezifischer Instruktionen abstrahiert. "TileLang wurde genau für diesen Bedarf entwickelt", sagte DeepSeek - den Bedarf an einem Programmiermodell, das über verschiedene KI-Beschleunigerarchitekturen hinweg funktioniert, ohne dass Entwickler chipspezifische Assemblersprachen lernen müssen.
Die Veröffentlichung umfasst mehr als nur TileLang. DeepSeek veröffentlichte auch Ascend-optimierte Versionen von fünf Kernsoftwarekomponenten, die in seinem eigenen V4-Serien-Training verwendet werden: DeepGEMM für Matrix-Multiplikation, DeepEP für geräteübergreifende Kommunikation, TileKernels für Vektor-Computing, FlashMLA für sparse Attention-Mechanismen und DeepSelect für Datenfilterung. Jeder TileLang-Operator, der in DeepSeeks V4-Training verwendet wird, hat jetzt eine leistungsstarke Ascend-Implementierung.
Entscheidend ist, dass dieselben Python-Schnittstellen sowohl Nvidia-GPUs als auch Huawei-NPUs unterstützen. Das Backend wird automatisch basierend auf der Hardware ausgewählt. Ein Entwickler, der Code in TileLang schreibt, kann ihn heute auf einem Nvidia-H100-Cluster und morgen auf einem Ascend-NPU-Cluster ausführen, ohne eine einzige Zeile umschreiben zu müssen. Diese Art von plattformübergreifender Kompatibilität hat CUDA nie geboten - und genau das wünschen sich Entwickler, die Flexibilität brauchen.
Das 128-Chip-Supernode
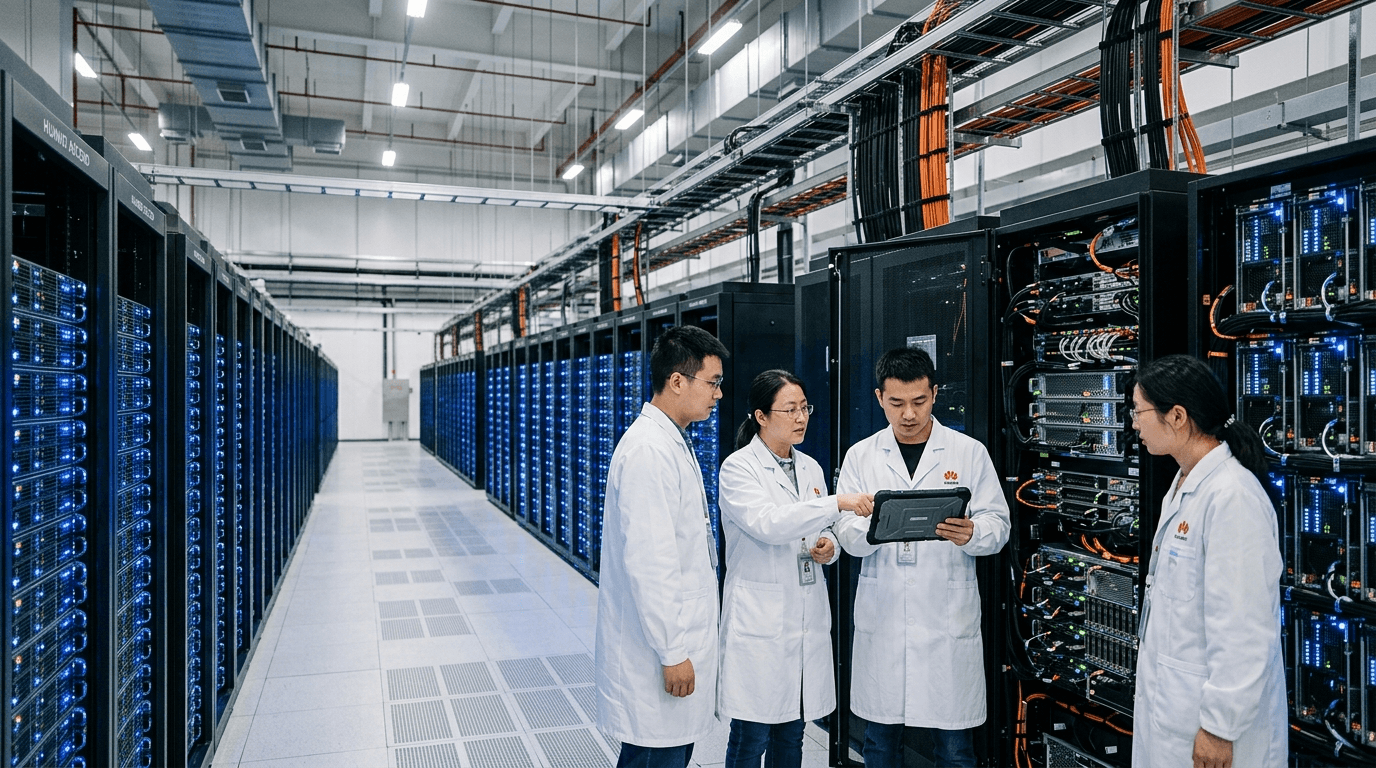
Das Hardware-Ziel dieser Toolchain ist das Ascend-950-Supernode, ein System, das 128 Huawei Ascend-Prozessoren zu einem einzigen Computing-Cluster verbindet, optimiert für groß angelegte KI-Workloads. DeepSeek und Huawei optimierten gemeinsam die Computing- und Kommunikationsebenen für diese spezifische Konfiguration.
Die 128-Chip-Zahl ist strategisch wichtig. Nvidias Vorteil lag nie nur in der Geschwindigkeit einzelner GPUs - es war der NVLink-Interconnect, der GPUs mit Geschwindigkeiten kommunizieren lässt, die Konkurrenten nicht erreichen können. Beim Training eines großen Modells über Hunderte oder Tausende von Prozessoren hinweg ist der Kommunikationsengpass zwischen den Chips oft wichtiger als die Rohgeschwindigkeit eines einzelnen Chips. Indem sie ihre eigene Verbindungsstruktur um das Ascend 950 herum bauen und DeepSeeks Software-Stack speziell dafür optimieren, greifen DeepSeek und Huawei Nvidia an seinem stärksten Punkt an - der Fähigkeit, effizient über mehrere Chips zu skalieren.
Was das für Nvidia bedeutet
Nvidias Reaktion wird entscheidend sein. Das Unternehmen weiß seit Jahren, dass China heimische Chip-Alternativen braucht - US-Exportkontrollen haben dafür gesorgt. Aber die Bedrohung wurde immer als Hardware-Problem dargestellt: Können chinesische Chip-Hersteller Prozessoren bauen, die Nvidias Spezifikationen erreichen?
TileLang verschiebt die Frage. Selbst wenn Huaweis Ascend-Chips nie die rohe Leistung pro Chip von Nvidia erreichen, schwächt ein Software-Ökosystem, das Entwicklern erlaubt, sowohl Nvidia- als auch Nicht-Nvidia-Hardware mit demselben Code anzusprechen, CUDAs Lock-in-Effekt. Ein chinesisches KI-Labor, das evaluiert, ob es auf Ascend- oder Nvidia-Clustern aufbauen soll, steht nicht mehr vor einer binären Wahl - die Software-Ebene unterstützt jetzt beide.
Das Timing ist auch bezeichnend. Huawei hat kürzlich seine nächste Generation von KI-Prozessoren vorgestellt und erwartet eine breitere Bereitstellung für Modelltraining im Jahr 2027. TileLang gibt diesen Chips ein sofort einsatzbereites Software-Fundament und beschleunigt die Adoption genau in dem Moment, in dem die chinesische KI-Nachfrage explodiert.
Die skeptische Betrachtung
TileLang ist kein CUDA-Killer. Noch nicht.
Nvidias Ökosystemvorteil ist jahrzehntelang gewachsen - Dokumentation, Debugging-Tools, optimierte Bibliotheken für jede erdenkliche Workload und eine Entwicklerpopulation in Millionenhöhe. TileLangs Dokumentation startete auf WeChat. Seine Entwickler-Community ist bei Null. Und obwohl plattformübergreifende Kompatibilität technisch wertvoll ist, optimieren die meisten KI-Teams ohnehin für ein einziges Hardware-Ziel - sie wollen die schnellstmögliche Implementierung, nicht die portabelste.
Was TileLang stattdessen schafft, ist Optionalität. Für chinesische KI-Labore, die mit Versorgungsunsicherheit bei Nvidia-Hardware konfrontiert sind, senkt TileLang die Umstellungskosten auf heimische Chips. Für Huawei bietet es eine Entwickler-Einstiegsrampe, die es vorher nicht gab. Und für die gesamte Branche zeigt es, dass die Software-Ebene um KI-Hardware herum kein dauerhaftes Monopol mehr ist - sie kann herausgefordert werden, ein Open-Source-Repository nach dem anderen.
Der CUDA-Burggraben ist nicht verschwunden. Aber er hat jetzt einen Riss, und beide Seiten wissen es.
Quellen
- DeepSeek, Huawei Build 128-Chip AI System to Challenge Nvidia - Analytics Insight
- DeepSeek and Huawei Target a Key Source of Nvidia's A.I. Dominance - The New York Times (via Google News)
- DeepSeek partners with Huawei to develop chip programming tools - Reuters (via Google News)
- DeepSeek opens tools to help Huawei chips supplant Nvidia in AI - South China Morning Post (via Google News)
- DeepSeek's new Huawei partnership could reshape China's AI chip race - WIONews (via Google News)